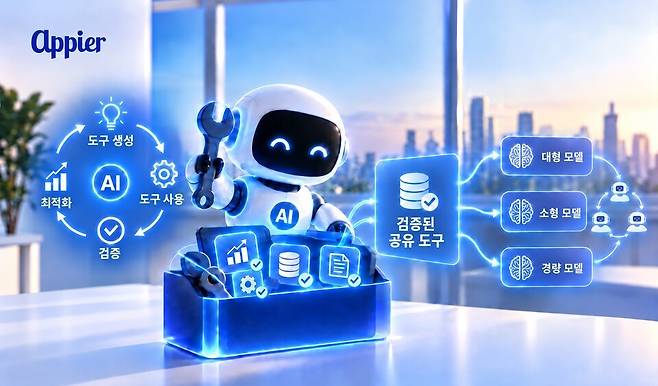
AI 에이전트가 주어진 도구를 사용하는 데서 나아가 필요한 도구를 직접 만들고, 실제 사용 결과를 반영해 다시 개선하는 학습 방식이 제시됐다. 애피어(Appier)는 이 방식을 적용한 연구에서 반복 추론에 사용되는 출력량을 평균 3206토큰에서 약 100토큰으로 줄였다고 밝혔다.
애피어는 연구 논문 '거대언어모델 에이전트를 위한 도구 생성과 활용의 공동 최적화(Joint Optimization of Tool Creation and Use for Large Language Model Agents)'가 AI·머신러닝 학회 NeurIPS에 채택됐다고 1일 밝혔다.
논문의 중심에는 'SMITH(Schema-grounded Multi-task Iterative Tool Honing)'라는 강화학습 프레임워크가 있다. 기존 AI 에이전트 연구에서 따로 다루던 도구 생성과 도구 사용을 하나의 학습 과정으로 묶은 것이 특징이다.
작동 방식은 '생성-사용-검증-개선'의 반복이다. AI가 문제 해결에 필요한 도구를 만든 뒤 직접 사용하고, 설명이 불명확하거나 파라미터 설계가 적절하지 않아 실행이 실패하면 그 결과를 다시 학습에 반영한다.
도구 내부 코드 자체보다 설명과 파라미터 정보가 실제로 다른 AI 모델에게 얼마나 명확하게 전달되고 정확하게 호출되는지도 평가 대상이 된다. 결국 도구를 '만드는 능력'뿐 아니라 다른 에이전트가 실제로 활용할 수 있는 형태로 만드는 능력까지 함께 훈련하는 구조다.
학습 과정도 비교적 적은 예제로 시작한다. SMITH는 먼저 4개의 간단한 문제로 문제 해결 방법과 도구 생성을 학습한 뒤, 학습 과정에서 보지 않은 16개의 더 어려운 문제로 일반화 성능을 검증한다.
새로운 문제를 성공적으로 해결한 도구만 여러 에이전트가 함께 사용할 수 있는 공유 라이브러리에 등록한다. 이후 더 좋은 성능을 내는 도구가 만들어지면 기존 도구를 대체한다.
애피어가 공개한 실험에서는 모델 크기보다 도구 생성 방식이 성능에 영향을 미칠 수 있다는 결과도 나왔다. SMITH로 학습한 약 40억 파라미터 규모 모델이 만든 도구는 학습하지 않은 과제에서 연구가 비교한 다른 방법보다 높은 성능을 기록했다. 약 300억 파라미터 규모 모델이 문제마다 즉석에서 도구를 생성하는 베이스라인보다도 높은 결과가 나왔다.
다만 이는 이번 연구의 실험 조건과 비교 대상 안에서 나온 결과다. 일반적으로 40억 파라미터 모델이 300억 파라미터 모델보다 성능이 높다는 의미는 아니다.
생성한 도구를 다른 모델이 재사용할 수 있다는 점도 확인됐다. 약 40억 파라미터 모델이 만든 도구를 약 3억5000만 파라미터 규모의 경량 모델에 적용했을 때도 새로운 과제를 처리할 수 있었고, 더 큰 모델이 같은 도구를 사용했을 때에도 성능 개선이 나타났다고 연구진은 설명했다.
토큰 사용량을 줄인 결과도 눈에 띈다. 문제를 풀 때마다 전체 추론 과정을 반복하는 대신 검증된 과정을 도구로 만들어 호출하는 방식으로 바꾸면서 평균 출력량이 기존 3206토큰에서 약 100토큰으로 줄었다. 단순 수치로는 약 32분의 1 수준이다.
이 방식은 여러 AI 에이전트가 역할을 나누는 환경에서 활용도가 높을 수 있다. 한 에이전트가 효과적인 도구를 만들어 검증하면 다른 에이전트가 모델 크기와 관계없이 이를 재사용할 수 있기 때문이다.
기업 업무에서도 반복적인 데이터 처리나 재무 지표 변환, 보고서 조회, 규정 확인, 고객 문의 분류 등을 매번 처음부터 추론하지 않고 검증된 도구 형태로 축적할 수 있다는 게 애피어의 설명이다.
광고·마케팅 분야에서는 고객 데이터와 개인화, 고객 서비스, 광고 구매를 담당하는 여러 에이전트가 동일한 도구와 비즈니스 규칙을 공유하는 방식으로 확장할 수 있다.
치한 위 애피어 공동창업자 겸 최고경영자(CEO)는 "인간이 문제 해결 경험을 도구로 만들어 재사용해 왔듯 AI 에이전트도 같은 방식으로 발전할 수 있다"며 "효과가 확인된 도구를 서로 다른 규모의 모델이 함께 활용하면 멀티 에이전트 협업의 효율성과 확장성을 높일 수 있다"고 말했다.
치에옌 린 애피어 리서치 사이언티스트는 "모델이 도구 사용법을 배울 때 내부 코드가 아닌 도구 설명과 파라미터 정보를 참고한다"며 "도구 설명의 명확성과 호출 성공 여부가 직접적인 학습 피드백으로 작용한다"고 설명했다.