왜 학교를 폭격 목표로 추천했나… ‘AI 머릿속’ 들여다본다
전체 맥락을 이해하기 위해서는 본문 보기를 권장합니다.
올 2월 28일 이란 남부 미나브 지역 샤자레 타예베 초등학교가 폭격당해 어린이와 교사 최소 157명이 사망했다. 미군의 인공지능(AI) 군사 기술 '메이븐 스마트 시스템'(메이븐)의 잘못된 표적 설정이 원인으로 지목됐다.
미국 AI 기업 앤스로픽의 '해석 가능성팀'이 올 2월 AI '클로드' 내부에서 AI가 잘못 훈련되는 과정을 포착한 것이 대표적인 '기계적 해석 가능성' 연구 사례다.
이 글자크기로 변경됩니다.
(예시) 가장 빠른 뉴스가 있고 다양한 정보, 쌍방향 소통이 숨쉬는 다음뉴스를 만나보세요. 다음뉴스는 국내외 주요이슈와 실시간 속보, 문화생활 및 다양한 분야의 뉴스를 입체적으로 전달하고 있습니다.
이란 학교 오폭 ‘AI 책임론’ 부상
판단 근거 설명 ‘XAI 연구’ 진전
모델 내부 정보 처리 과정 추적
“독립적 검증 위한 정보공개 필요”
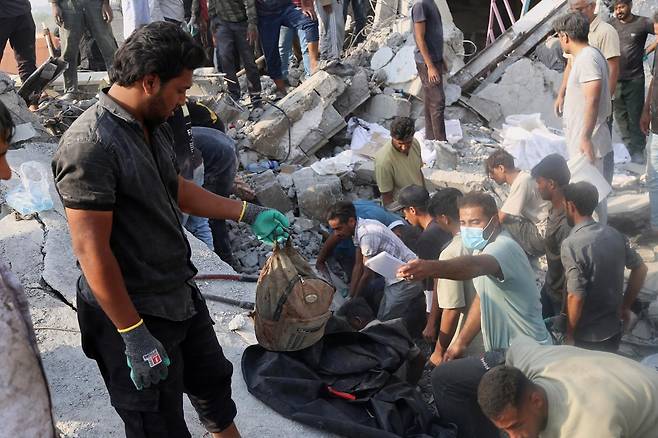
오폭 사건으로 ‘AI 블랙박스’ 문제가 수면으로 떠올랐다. AI 블랙박스는 AI가 입력값을 받아 어떻게 특정 결과를 도출하는지 내부 추론 과정을 이해할 수 없는 현상이다.
22일 학계에 따르면 과학자들이 AI가 내놓은 결과에 기여한 변수는 물론 AI 모델의 내부 회로까지 들여다보는 연구를 내놓고 있지만 AI 블랙박스 문제를 완전히 해결하려면 근본적으로 AI 기업의 정보가 공개돼야 한다는 전문가들의 지적이 이어지고 있다.
● 결과에 기여한 변수부터 모델 회로까지 살핀다
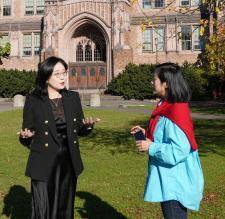
AI 블랙박스 문제를 해결할 연구로 ‘설명 가능한 AI(XAI)’와 ‘기계적 해석 가능성’이 거론된다. XAI는 AI 모델이 내놓은 결과에 기여한 변수를 설명하는 게 목표다. 이수인 미국 워싱턴대 컴퓨터과학과 교수가 2017년 발표한 ‘SHAP’ 기술이 대표적이다. 수학 이론을 토대로 AI에 입력되는 변수의 기여도를 분석하는 기술이다. 워싱턴대에서 만난 이 교수는 “마취의 대표적인 부작용인 저산소증을 경고하는 의료 AI 시스템을 개발하던 중 ‘경고를 하는 원인, 이유가 정확해야 한다’는 마취과 의사들의 이야기가 연구의 계기가 됐다”고 설명했다.
XAI 연구는 현재 변수의 기여도 분석을 넘어 가상의 조건에 따라 AI 판단 결과가 얼마나 달라지는지 찾는 수준까지 왔다. 포스카 잔노티 이탈리아 피사고등사범학교 컴퓨터과학과 교수는 AI의 판단 과정을 모방해 변수가 다른 여러 사례에서 각각의 변수가 최종 판단에 어떤 영향을 미치는지 ‘인과관계’를 밝히는 ‘ILLUME 기술’을 지난해 공개했다.
‘기계적 해석 가능성’ 연구는 AI 모델 내부에서 정보가 처리되는 과정을 밝힌다. AI 모델 내부에서 정보와 개념이 어떻게 표현되는지, 이 정보가 어떤 회로를 통해 상호 작용하는지 직접 들여다본다. 미국 AI 기업 앤스로픽의 ‘해석 가능성팀’이 올 2월 AI ‘클로드’ 내부에서 AI가 잘못 훈련되는 과정을 포착한 것이 대표적인 ‘기계적 해석 가능성’ 연구 사례다.
에마뉘엘 에미슨 앤스로픽 AI 해석 가능성팀 연구원은 “AI 모델이 수학 계산을 한 뒤 26(정답)과 48(오답) 사이에서 갈팡질팡하길래 내부를 들여다보자 ‘정답이 48이다’는 표상이 강력하게 활성화돼 있었다”고 설명했다. 표상은 모델이 개념이나 정보를 내부에 드러내는 방식을 의미한다. 이를 통해 앤스로픽은 AI 모델이 훈련 과정에서 계산 과정을 48이라고 답했을 때 보상을 받았다는 사실을 알게 됐고 모델의 오류를 개선했다.
● “독립 연구자들이 기업 시스템 들여다봐야”
문제는 이들 기술은 아직 충분히 AI 블랙박스를 설명하지는 못한다는 점이다. 전문가들은 AI 기업의 정보 공개를 유도할 방안이 마련돼야 한다고 말한다. 라이언 칼로 워싱턴대 로스쿨 석좌교수는 “기업과 이해관계가 없는 독립 연구자들과 내부고발자에게 시스템을 자유롭게 조사하고 발견한 내용을 보고할 수 있게 권한을 부여하고 보호해야 한다”고 말했다.
기업의 정보 공개를 제도화하는 노력도 필요하다는 지적이다. 캐서린 스트랜드버그 미국 뉴욕대 로스쿨 교수는 “미국 정부가 약물의 안전성 검증을 위해 미국 식품의약국(FDA)에 정보를 제출하도록 요구하듯 공정한 경쟁 환경을 만들면서 기업이 정보를 공개할 방법을 고민해야 한다”고 강조했다.
※본 기사는 정부 광고 수수료로 조성된 언론진흥기금의 지원을 받았습니다.
장효빈 동아사이언스 기자 robyne98@donga.com
김태희 동아사이언스 기자 taehee@donga.com
Copyright © 동아일보. All rights reserved. 무단 전재, 재배포 및 AI학습 이용 금지
- “내일 블랙 먼데이 막자”…정부, 증안펀드 18년만에 투입 준비
- ‘李 공소취소 예·아니오 답하라’에…이용철, 또 “법과 원칙 따라야”
- 李 “돼지 눈엔 돼지만…해외 순방, 치아 흔들리고 코피 터지는 일”
- “앨리스 황은 ‘얼굴 마담’…52세 中남성이 엔비디아칩 밀수 주도”
- [단독]“OECD 가입 30년 한국, 기업간 AI활용 격차 해소에 미래달려”
- 축제 된 쇼트트랙 월드투어…韓 남자계주, 안방 경기서 0.264초차 금메달
- 멜라니아, 트럼프와 결혼 유지 비결? “서로 있는 그대로 받아들여야”
- [사설]조 대법원장 탄핵은 안 된다… 이 대통령이 제동 걸어야
- [사설]최교진 사퇴… ‘대학선발권 강화’ 입시제도 개편 시동 걸 때
- [사설]中 전기차 韓 점유율 상전벽해… 넋 놓다 안방 내준다