노타, 초거대 AI '키미 K3.1 Pro' 최적화…GPU 구매비용 최대 20% 절감
전체 맥락을 이해하기 위해서는 본문 보기를 권장합니다.
AI 추론 효율화 기업 노타는 문샷AI의 초거대 모델 '키미 K3.1 Pro(Kimi K3.1 Pro)'를 최적화해 GPU 초기 구매비용을 최대 약 20% 낮췄다고 10일 밝혔다.
기존에는 엔비디아 최신 B300 GPU 8장이 필요했던 모델을 상대적으로 구매비용이 낮은 B200 GPU 8장에서도 실행할 수 있도록 최적화했다.
이 글자크기로 변경됩니다.
(예시) 가장 빠른 뉴스가 있고 다양한 정보, 쌍방향 소통이 숨쉬는 다음뉴스를 만나보세요. 다음뉴스는 국내외 주요이슈와 실시간 속보, 문화생활 및 다양한 분야의 뉴스를 입체적으로 전달하고 있습니다.
추론 성능 99% 유지하며 구매비용 절감
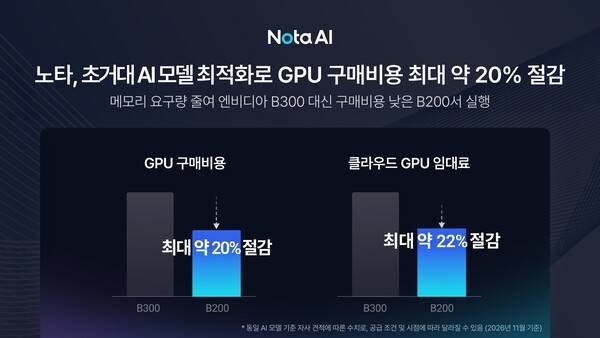
AI 추론 효율화 기업 노타는 문샷AI의 초거대 모델 '키미 K3.1 Pro(Kimi K3.1 Pro)'를 최적화해 GPU 초기 구매비용을 최대 약 20% 낮췄다고 10일 밝혔다.
기존에는 엔비디아 최신 B300 GPU 8장이 필요했던 모델을 상대적으로 구매비용이 낮은 B200 GPU 8장에서도 실행할 수 있도록 최적화했다. 기업과 개발자는 B300을 새로 확보하는 대신 기존 B200 인프라를 활용하거나 신규 도입 시 저렴한 구성을 선택할 수 있게 됐다. 자사 견적 기준 동일 모델 구동 시 B300 대신 B200을 활용하면 GPU 구매비용은 최대 약 20%, 클라우드 임대료는 최대 약 22% 절감할 수 있다.
키미 K3.1 Pro는 2조8000억 개의 매개변수를 갖춰 현재 공개된 오픈웨이트 AI 모델 중 최대 규모다. 노타는 모델 내부 전문가 모듈을 선별적으로 제거하는 프루닝(Pruning) 기술을 적용해 전문가 모듈을 최대 37% 줄였다. 메모리 요구량을 낮췄음에도 고난도 과학 추론 능력을 평가하는 'GPQA Diamond' 지표에서 원본 모델 점수의 99% 이상을 유지했다.
확보한 여유 메모리 공간은 긴 문맥 처리와 답변 생성 가속에 활용했다. B200 GPU 8장 환경에서 전문가를 30% 줄인 모델은 최대 51만2000토큰, 37% 줄인 모델은 최대 100만 토큰의 문맥을 한 번에 처리한다. 또한 작은 보조 모델이 다음 내용을 제안하고 본 모델이 검증하는 '추측 디코딩(Speculative Decoding)'을 지원해 B200 환경에서도 답변 생성 속도를 높였다.
앞서 노타는 키미 K3의 실행에 필요한 B300 GPU를 기존 8장에서 최대 4장으로 줄인 바 있다. 이번 후속 모델에서는 최신 하드웨어 요구 사양을 낮추는 방식의 최적화 역량을 입증했다.
채명수 노타 대표는 "AI 산업의 경쟁력은 더 많은 고성능 GPU를 확보하는 것뿐 아니라, 이미 보유한 컴퓨팅 자원에서 얼마나 높은 성능과 효율을 구현하느냐에 달려 있다"며 "이번 성과는 초거대 AI 모델의 주요 추론 성능을 유지하면서 하드웨어 요구 조건을 낮춰 AI 도입의 경제성을 개선할 수 있음을 보여준다"고 말했다.
이어 "노타는 모델 경량화부터 추론 실행과 서빙 최적화까지 기술 적용 범위를 확대하고 있다"며 "기업들이 기존 AI 인프라를 더욱 효율적으로 활용하고 새로운 모델을 합리적인 비용으로 도입할 수 있도록 최적화 소프트웨어 사업을 강화할 것"이라고 밝혔다.
Copyright © EBN