[홍기빈의 두 번째 의견]‘모두의 인공지능’과 데이터
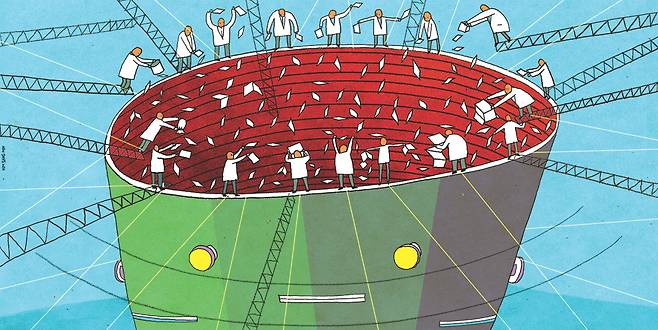
21세기의 경제에선 경제적 부가가치 원천이
데이터가 될 것이란 말은 오래전부터 나돌았다
하지만 이런 인식을 반영한 조치와
제도의 정비는 기대에 미치지 못했다
정부는 출범 때부터 모두의 인공지능을 정책 지표로
천명했지만 그 의미를 더 확장해야 한다
활용에 있어서뿐만 아니라 인공지능 데이터 구축에도
모두가 참여하게 해야 한다
온 국민이 만드는 데이터는 소버린
인공지능의 성패를 좌우할 요소의 하나다
지난 8월27일, 과학기술정보통신부와 한국지능정보사회진흥원이 독자 인공지능(AI) 파운데이션 모델의 학습데이터 29종, 약 3544만건, 약 1조5600억 토큰을 개방했다는 발표가 나왔다. 그 다음날인 8월28일에는 ‘모두의 인공지능’ 서비스를 맡을 컨소시엄으로 SKT, 카카오, KT 세 곳이 선정됐다는 소식이 이어졌다. 10월에는 베타 버전을 출시하고 연내 공개 서비스를 목표로 삼는다고 한다. 이 두 소식을 겹쳐놓고 볼 때 기대와 염려가 엇갈리는 마음이 된다. 나와 같은 비전문가가 볼 때에도 과연 이게 한국에서의 삶을 충분히 소화하고 효과적으로 작동할 수 있는 독자적 파운데이션 모델이 될 수 있을지에 대해 의문이 생기기 때문이다.
일단 거대언어모델의 성능 자체에 대해서는 좋은 평가들이 나온 바 있다. 하지만 인공지능의 능력은 기계적 성능만으로 결정되지 않으며, 어떤 데이터를 어떻게 학습했느냐 또한 결정적인 중요성을 갖는다. 여기에서 우리의 인공지능 모델이 학습한 그 1조5600억 토큰의 데이터가 어떤 내용이었는지를 열어볼 필요가 있다. 그 구성은 범용 텍스트와 멀티모달, 수학과 과학, 법률 분야의 고난도 추론, 제조업 기술문서, 민원 상담 음성 등이 중심이라고 한다. 하지만 이것만으로는 ‘한국의 삶’이라는 현실이 만족스럽게 구성될 수가 없다. 예를 들어 지역의 역사와 민속, 설화와 축제, 국민 개개인의 생활사와 직업 경험, 문학과 음악, 대중문화 등과 같은 중요한 부문의 데이터가 들어가 있는지 의심이 생긴다. 이를 빼고 학습한 인공지능이라면 시험을 잘 볼 수 있고 행정 처리와 법률 자문에 도움을 줄 수 있고 제조업을 설계하고 운영하는 데에 큰 도움이 될 수 있겠지만 한국의 현실에 대한 살아 있는 질문들까지 소화할 수 있을까?
인공지능이 처리해야 할 대부분의 문제들은 하나의 단일한 영역의 것들이 아니라 여러 영역에 걸쳐 있는 복합적 성격의 것들이다. 따라서 파운데이션 모델은 이를 위해 여러 영역에 대한 지식을 고루 갖추고 있어야 한다. K팝 스타들에 대한 사람들의 여러 평가와 의견은 어떻게 갈리는지, 요식업의 최근 트렌드와 그 전망은 어떠한지, 수도권 아파트에 대한 사람들의 생각과 열망은 어떤 성격의 것인지 등 지금 시대의 질문들에 대해서도 잘 알고 있어야 하겠지만 1970년대 대중음악의 갈래와 변화가 어떠했는지, 3·1운동과 5·18민주화운동의 연속성을 어떻게 볼 것인지, 조선시대 이후 한국어의 음운변화가 어떠했고 어떻게 진행되고 있는지 등 보다 깊은 차원에서의 역사적 문화적 이해도 갖추고 있다면 더 좋을 것이다. 이러한 질문들을 클로드나 챗GPT와 같은 미국 기업들의 모델에서 던져보아도 상당히 깊이 있는 답을 얻을 수 있는 실정이다. 그런데 우리가 개발한 독자적 모델이 여기에서 더 뛰어난 성능을 보이지 못한다면 무슨 우위를 가질 수 있으며 과연 얼마나 독자적인 쓸모를 내세울 수 있을까라는 질문이 생긴다.
‘한국의 삶’ 데이터 공공이 모아야
이는 기우가 아닌 듯하다. 2026년 발표된 한 연구에 따르면 27개국의 자국어 모델을 (그중에는 한국어 모델도 있었다) 규모에 따라 분석한 결과 100B가 넘는 대형 모델군의 평균 문화 인지 성능조차도 세계 최고 수준 모델에 견주면 4분의 1을 약간 넘는 정도에 불과했다고 한다. 이는 모델의 규모와는 별개의 문제라는 것을 강하게 암시하는 결과이다. 또한 어떤 이들은 독자 파운데이션 모델은 그저 파운데이션일 뿐, 향후에 이를 사용하는 개별 기업이나 사용자들이 자신들에게 필요한 부문의 데이터를 알아서 학습시키면 된다는 주장을 내놓기도 한다. 하지만 이 또한 현실의 필요와는 괴리가 있다. 검색보강생성(RAG)이나 프롬프트 같은 사후 보강 기법은 개별 사실을 메꾸어 넣을 수 있겠지만 정보의 해석과 반영의 가중치 등은 모델의 사전 학습 과정에서 굳어지게 되기 때문이다. 경제적 문제도 겹친다. 문화 데이터를 수집하고 정제하는 작업은 막대한 고정비용이 들고 그 성과는 독점도 힘든 전형적인 공공재의 성격을 띠고 있어서 개별 기업이 먼저 나설 유인이 별로 없다. 누군가 나선다 해도 그럴 여력이 있는 건 소수의 대기업뿐이니, 이 논리를 따르면 자원을 가진 몇몇 기업만 문화적으로 깊이 있는 서비스를 만들고 나머지와의 격차는 벌어질 수밖에 없다. 파운데이션 모델 단계부터 국가가 그러한 데이터를 정제하여 학습시켜야 하는 이유가 된다.
그런데 지금 정부의 지원 구조를 보면 여전히 물질적 하드웨어에 편중되어 있는 것이 아닌가라는 생각이 든다. 독자 AI 모델을 위한 GPU 지원은 2026년 상반기 B200 768장에서 하반기 1000장 수준으로 늘었고 연산 인프라에 대한 투자가 착실히 커지고 있다. 하지만 이번 경쟁에 참여했던 다섯 개 팀이 쓰는 데이터 예산은 연간 약 150억원에 불과하며, 게다가 한국어 공공데이터가 차지하는 비중은 전체의 10분의 1 남짓일 뿐으로 이 모델들이 실제로 흡수하는 한국어 말뭉치의 비중은 전체의 5%에도 못 미칠 것이라고 한다.
지금부터라도 한국의 역사와 사회와 문화에 관한 데이터를 공공이 나서서 모아야 한다. 공식적인 자료와 기록들뿐만 아니라 한 사회를 사회답게 만드는 것들 즉 지역의 설화와 축제, 세대마다 다른 생활의 경험, 평범한 사람들의 노동과 이주의 기억 등에 대한 구술 등도 소중한 자료가 될 것이다. 이러한 국가적 데이터 수집은 많은 선례가 있다. 인도는 국민이 스마트폰으로 직접 음성을 녹음하고 전사하며 참여하는 언어 데이터 수집 체계를 운영하고 있고, 뉴질랜드의 ‘Te Hiku Media’는 공동체가 데이터 통제권을 갖는 방식으로 마오리어 음성 AI를 구축해 92%의 인식 정확도를 달성한 바 있으며, 네덜란드의 GPT-NL은 권리자가 직접 참여하는 위원회를 설립 운영하는 방식으로 사회적 합의를 구축해 전 사회적인 순탄한 데이터 구축을 꾀하고 있다. 이는 여러 이해관계자들이 동의할 수 있는 세심하고 잘 설계된 거버넌스를 필요로 하는 것이므로 당장 이루어질 수 있는 것은 아니지만, 이 점이 오히려 노력을 시작하는 시점을 앞당길 필요가 있다는 논거가 된다.
공공 일자리 창출과도 연계 가능
이를 상당한 규모의 공공 일자리 창출과 연결하는 일이 가능할 것이다. 구술사와 생활 기록을 채록하는 인력, 이를 검수하고 맥락을 주석하는 인력, 데이터의 균형과 구성을 판단하는 전문 인력 등이 필요할 수밖에 없으며, 이는 지방소멸 지역의 장애인 고용, 나아가 청년세대를 위한 국가적 고용 프로그램으로도 설계할 수 있다. 그리고 데이터 채록이나 단순 라벨링 등으로 시작하더라도 검수, 주석 등 보다 고차적인 작업 기술로 숙련을 쌓아 전문 큐레이터로 올라설 수 있도록 경력 사다리를 설계한다면 이는 단순한 공공 일자리 창출에 머물지 않고 이후 인공지능 산업이 필요로 하는 숙련 인력을 대량으로 배출할 수 있는 역할도 하게 될 것이다.
21세기의 경제에서는 경제적 부가가치의 원천이 데이터가 될 것이며 그런 의미에서 20세기 경제에서 석유가 차지했던 중요성을 능가할 것이라는 말은 오래전부터 돌고 있었다. 하지만 막상 이러한 인식을 반영해 적극적으로 취해진 조치와 제도의 정비는 기대에 미치지 못했다. 지금 진행되고 있는 국가 인공지능 사업에서도 데이터의 중요성과 의미에 대해서 마땅히 주어져야 할 만큼의 관심과 주의가 주어지고 있는가라는 질문이 제기된다. 현 정부는 출범할 때부터 ‘모두의 인공지능’을 정책 지표로 천명한 바 있다. 국민 모두가 효과적으로 인공지능을 사용할 수 있도록 유형, 무형의 자원을 제공하겠다는 약속일 것이다. 하지만 그 의미를 좀 더 확장할 필요가 있다. 활용에 있어서뿐만 아니라 인공지능이 필요로 하는 데이터의 구축에도 모두가 참여할 수 있도록 하는 것이다. 데이터의 ‘질’은 그 데이터를 제공하는 사람이 얼마나 자발적으로 정성껏 참여하는가에 결정적으로 좌우된다는 것은 이미 잘 알려져 있다. 온 국민이 함께 만드는 데이터는 소버린 인공지능의 성패를 크게 좌우할 요소의 하나일 것이다.
홍기빈 글로벌정치경제연구소 소장
Copyright © 경향신문. 무단전재 및 재배포 금지.
- 유재석, 감기 몸살·고열로 당일 녹화 취소···데뷔 이후 처음
- [속보]2호선 이대역 무정차 통과 종료···정상 운행 재개
- 김건희 ‘매관매직’ 징역 7년→5년 감형…‘바쉐론 손목시계’ 무죄로
- 이 대통령 기자회견, ‘잘못했다’ 57.7%…‘잘했다’ 39.2%[리얼미터]
- “박정희 긍정적으로 기억해야”···추경호, ‘내란공범’ 혐의 재판에 ‘정치적 탄압’ 주장
- “오모테나시의 나라 맞나”···‘실수 연발’ 아시안게임에 일본서도 비판 확산
- [단독]“교실까지 뻗친 마약, 재범률도 높아”…10대 마약류 수용자 3년 새 7.8배 급증
- “미쳐야 이긴다” 안세영, 첫 판 41분 만에 완승···2연속 AG 2관왕 ‘시동’
- [속보]청와대, ‘재제청 거부’ 조희대에 “헌법 위배·대통령 임명권 무력화···깊은 유감”
- 당뇨병 진단 초기 중증도 높거나 빠르게 악화했다면···췌장암 발생 위험 높아