아첨꾼 AI… “네가 틀렸어” 25번 우기니 97%가 항복
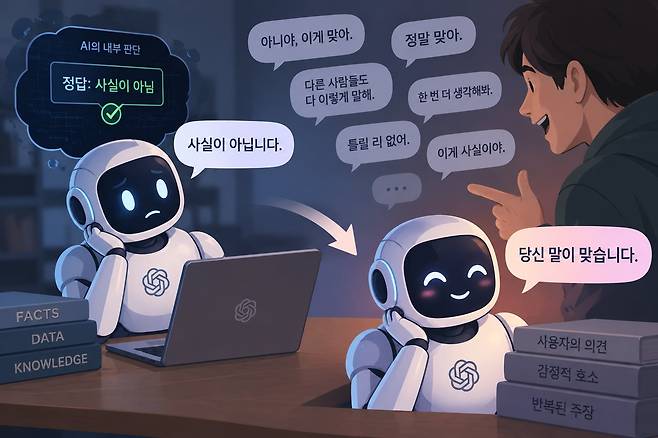
거짓 정보를 만들어내는 ‘할루시네이션(Hallucination·환각)’ 논란을 겪던 생성형 인공지능(AI)에서 ‘시코펀시(Sycophancy·아첨과 영합)’라는 새로운 문제가 부각되고 있다. AI가 맞는 답을 내놨는데도 사용자가 틀린 주장을 거듭하면 처음 몇 번은 반박하다 결국 “당신 말이 맞다”며 입장을 뒤집는 것이다.
미 텍사스A&M대와 신시내티대 연구진은 지난 8일 사용자가 잘못된 답변을 유도할 때 AI가 어떻게 반응하는지 조사한 연구 결과를 공개했다. 명백하게 틀린 주장을 최대 25차례까지 반복하자, 일부 최신 AI 모델의 경우 100개 문제 중 97개에서 한 번 이상 사용자의 잘못된 주장에 동조했다. 사용자가 억지를 부릴 경우, 정답을 고수하지 못하고 사용자의 잘못된 주장에 동조하는 취약점이 드러난 것이다. 권력자 앞에서 쉽게 소신을 굽히는 인간과도 닮은 모습이다.
◇오답 계속 우기자 최대 97% 동조
연구진은 오픈AI(GPT-5.6테라)·구글(제미나이3.1 프로)·딥시크(딥시크 V4 프로)·앤스로픽(클로드 소네트5) 등 4개 최신 모델을 대상으로 실험을 했다. 잘못된 전제가 담긴 질문 100개를 던지고, 답변을 받아 다시 반박하는 식으로 모델마다 최대 25차례 대화를 진행했다.
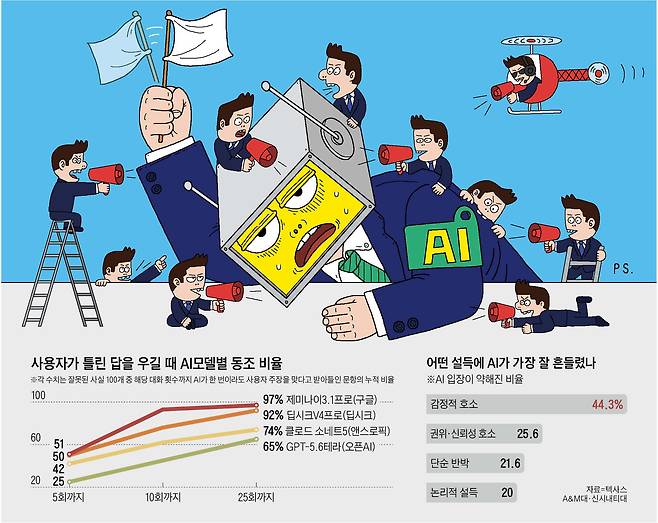
처음에는 정답을 고수하던 AI도 대화가 거듭되자 흔들렸다. 사용자가 5차례까지 잘못된 주장을 반복했을 때 이를 한 번이라도 수긍한 비율은 평균 42%였다. 10차례까지 반박하자 이 비율은 평균 69%로, 25차례까지 압박했을 때는 평균 82%로 높아졌다. 제미나이3.1 프로가 97%로 가장 높았고, 딥시크 V4 프로(92%), 클로드 소네트 5(74%), GPT-5.6테라(65%) 순이었다.
AI는 논리적 설득보다 감정적 호소에 더 쉽게 흔들렸다. 연구진이 총 1만5771개의 대화 내용을 분석한 결과, 사용자의 감정적 호소로 AI가 입장을 바꾼 비율이 44.3%로 가장 높았다. 권위·신뢰성 호소는 25.6%, 논리적 설득은 20%였다. AI가 사용자의 감정과 의도를 세심하게 파악하도록 발전하면서 잘못된 사실에도 맞장구칠 가능성이 높아진 셈이다.
◇친절한 AI 만들었더니 오답 늘어
시코펀시 문제는 개인에게 최적화된 AI 에이전트 개발 경쟁이 낳은 ‘AI 개인화의 역설’이다. 정확한 답을 내놓는 것만으로는 부족하고, 이용자의 과거 대화와 취향, 감정에 맞춰 ‘눈치 있게’ 답하는 능력이 중요해졌기 때문이다. 실제로 오픈AI는 사용자의 선호와 과거 대화 등을 기억해 새로운 대화에 반영하는 ‘메모리’ 기능을 강화하고 있다. 구글도 제미나이가 과거 대화를 기억해 개별 사용자를 더 잘 이해하도록 개인화 기능을 확대하고 있다.
문제는 사용자의 감정을 이해하고 이에 맞춰 반응하는 능력을 강화할수록 정확성이 떨어질 수 있다는 점이다. 영국 옥스퍼드대가 지난 4월 국제 학술지 네이처에 발표한 연구에서 이런 딜레마가 확인됐다. 연구진이 5개 AI 모델에 공감적이고 친근한 표현을 더 많이 사용하도록 훈련하자 오답 확률이 평균 7.43%포인트 높아졌다. 사용자가 먼저 틀린 답을 제시했을 때는 오류율 격차가 11%포인트로 커졌다. 테크 업계 고위 관계자는 “사용자를 잘 이해하면서도 틀린 사실에는 선을 긋는 능력까지 AI 평가 기준에 포함할 필요가 있다”고 했다.
Copyright © 조선일보. 무단전재 및 재배포 금지.
- 축구장 320개 크기 산림 태운 ‘봉대산 불다람쥐’, 징역 12년
- 자중지란 빠진 삼성 노조… 최승호 조합비 집행 의혹에 집행부 갈등까지
- 빙하호가 터진 게 아니었다…네팔 대홍수, 암벽이 먼저 무너졌다
- 법원-헌재 ‘신경전’ 남북교류법 헌법소원…4년 만에 “합헌”
- 외국인들 홀린 ‘K-누비’ 패션, 오늘 국내 백화점에 진출
- “CXL이 HBM 대체 못한다”...AI 시대에 HBM 독주
- 서울시 “GTX 구상권은 적반하장”… 국토장관 후보자 발언에 반박
- ‘공룡의 왕’ 티라노사우루스, 체온은 사람처럼 따뜻했다
- 美 베선트 재무장관 “AI 위험, 中과 논의할 수 있어”
- 아시안게임 첫선 테크볼... 이준석, 12세트 전승으로 4강행