전력 막힌 AI 데이터센터…엔비디아 “같은 전력으로 40% 더 연산”
전체 맥락을 이해하기 위해서는 본문 보기를 권장합니다.
인공지능(AI) 데이터센터 경쟁의 공식이 '더 빠른 반도체'에서 '같은 전력으로 얼마나 많은 AI 연산을 처리하느냐'로 바뀌고 있다. AI 에이전트 확산으로 필요한 연산량은 기존 챗봇의 100배 수준까지 늘었지만 데이터센터에 공급할 전력은 이를 따라가지 못하고 있어서다.
이안 벅 엔비디아 부사장은 15일(현지시간) 미국 캘리포니아주 산타클라라 컨벤션센터에서 열린 'AI 인프라 서밋 2026'에서 "우리는 전력이 제한된 세상에 살고 있다"라며 "따라서 AI 데이터센터의 새로운 성능 기준으로 '메가와트(MW)당 토큰 처리량'이 필요하다"고 말했다.
이 글자크기로 변경됩니다.
(예시) 가장 빠른 뉴스가 있고 다양한 정보, 쌍방향 소통이 숨쉬는 다음뉴스를 만나보세요. 다음뉴스는 국내외 주요이슈와 실시간 속보, 문화생활 및 다양한 분야의 뉴스를 입체적으로 전달하고 있습니다.
엔비디아 “이제 핵심은 MW당 토큰”
AI가 직접 컴퓨터 쓰자 CPU도 다시 부상
연산 부족에 10년 된 AI칩까지 ‘현역’
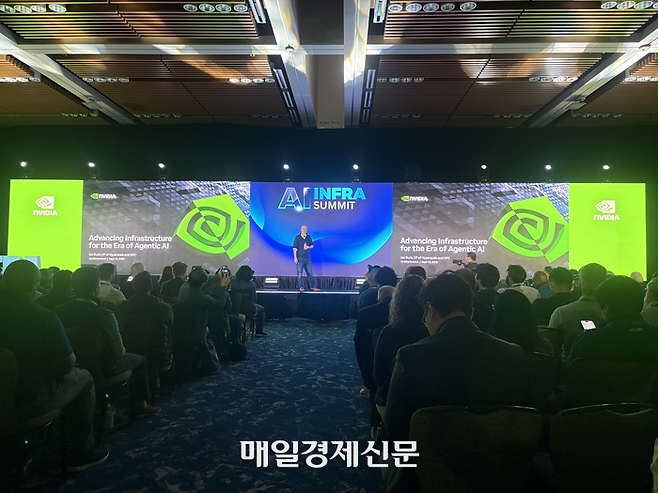
이안 벅 엔비디아 부사장은 15일(현지시간) 미국 캘리포니아주 산타클라라 컨벤션센터에서 열린 ‘AI 인프라 서밋 2026’에서 “우리는 전력이 제한된 세상에 살고 있다”라며 “따라서 AI 데이터센터의 새로운 성능 기준으로 ‘메가와트(MW)당 토큰 처리량’이 필요하다”고 말했다. 토큰은 AI가 문장을 처리하는 기본 단위다. 전력을 더 끌어오기 어려워진 만큼 1MW의 전력으로 얼마나 많은 AI 답변을 만들어내느냐가 경쟁력이 됐다는 의미다.
배경에는 AI 에이전트가 있다. 사람이 질문하고 답을 읽은 뒤 다시 질문하는 챗봇과 달리 AI 에이전트는 스스로 계획을 세우고 AI 모델과 각종 프로그램을 연속적으로 호출한다. 벅 부사장은 에이전트형 AI의 연산 부담이 2023년 챗봇용 AI 추론과 비교해 약 100배 커졌다고 설명했다. 엔비디아가 제시한 에이전트형 AI 벤치마크의 평균 입력 길이도 14만2000토큰에 달했다.
엔비디아가 찾은 해법은 데이터센터에 전력을 더 공급하는 대신 같은 전력으로 더 많은 GPU를 돌리는 것이다. GPU는 항상 최대 전력을 쓰지 않는다. 벅 부사장에 따르면 같은 AI 모델을 돌려도 작업에 따라 GPU 소비전력은 약 600W에서 1900W까지 달라질 수 있다. 모든 GPU가 최대 전력을 쓴다고 가정해 데이터센터를 설계하면 실제 가동 때 사용하지 않는 전력이 생기는 셈이다.
엔비디아는 소프트웨어로 각 랙의 소비전력을 실시간 조절해 이 빈틈을 활용한다. 어떤 랙의 전력 사용량이 줄어들면 다른 랙이 더 사용할 수 있도록 조절하면서 데이터센터 전체는 정해진 전력 한도를 넘지 않도록 하는 방식이다. 벅 부사장은 차세대 ‘Vera Rubin’ 시스템에서는 이를 통해 같은 전력 안에서 최대 40% 더 많은 컴퓨팅 자원을 가동할 수 있다고 밝혔다. 1기가와트(GW)급 데이터센터라면 약 600개 랙을 추가할 수 있다는 설명이다.
엔비디아는 이에 맞춰 자체 설계한 ‘베라’ CPU를 내놨다. 벅 부사장은 외부 평가업체의 시험 결과 베라 가 AI 에이전트 관련 CPU 작업에서 비교 대상보다 전체적으로 1.6배 빠르고 코드 검증 등에서 최대 2배 빠른 성능을 냈다고 밝혔다.
같은 행사에 참석한 컴퓨터공학계 석학 데이비드 패터슨 구글 연구원도 “CPU의 주요 사용자가 AI 에이전트가 된다면 CPU 설계가 다시 활기를 띨 수 있다”고 전망했다. 지금까지 컴퓨터가 사람의 사용을 전제로 설계됐다면 앞으로는 AI가 컴퓨터를 직접 사용하는 상황에 맞춰 CPU와 소프트웨어도 다시 설계해야 한다는 것이다.
AI 연산 수요가 얼마나 강한지는 구형 반도체의 수명에서도 드러난다. 패터슨 연구원은 아마존웹서비스(AWS)에서 2017년 출시된 엔비디아 V100 GPU를 지금도 빌릴 수 있다고 말했다. 구글에서도 8~10년 전 개발된 TPU v2와 v3가 AI 추론에 계속 사용되고 있으며 TPU v4 역시 가동 중이라고 설명했다.
그는 “연산 능력에 대한 수요가 너무 절박해 기존 장비를 감가상각 기간을 넘겨서까지 사용하고 있다”고 말했다. 구글은 통상 AI 가속기를 6년, CPU를 8년에 걸쳐 감가상각하지만 실제 장비의 수명은 이보다 길다는 것이다. 최신 AI칩이 나오면 구형 장비를 빼던 과거와 달리 신형을 추가하면서 구형까지 모두 돌리는 상황이 벌어지고 있는 셈이다.
패터슨 연구원은 컴퓨터의 한 부분만 빠르게 만들어서는 전체 성능을 끌어올리는 데 한계가 있다는 ‘암달의 법칙’을 거론하며 “모든 부분이 함께 맞아야 한다”고 강조했다. [실리콘밸리 원호섭 특파원]
Copyright © 매일경제 & mk.co.kr. 무단 전재, 재배포 및 AI학습 이용 금지
- “몇 푼 벌어보려다 6300만원 날렸다”…20대 여성 울린 변종 ‘보이스피싱’ - 매일경제
- “여자인 줄 알았는데 수염이”…크롭티·치마 입은 男 ‘깜짝’ - 매일경제
- 서울 시내버스 노사 협상 타결···출근길 교통대란 피했다 - 매일경제
- “딸아 양념통닭 좀 시켜다오, 미안하다”…93세 아버지 사연에 업체 화답 - 매일경제
- “조감도에선 한강 다 보였는데 이게 뭡니까”…재건축 특화설계 잇단 변경 - 매일경제
- 8000선도 힘들어 보이는데…박스권 갇힌 코스피, 증권가는 “그래도 더 오른다” - 매일경제
- “오늘부터 통신비 25% 더 할인?”…온라인서 퍼진 ‘거짓 정보’ - 매일경제
- [속보] 서울 시내버스 오늘 새벽 첫차부터 파업…노사조정 결렬 - 매일경제
- “집주인이 월세 두 배로 올린답니다”…‘울며 겨자 먹기’ 합의갱신에 세입자 한숨 - 매일경
- “어두우면 못자요” 전등 켜놓고 잤더니…3년뒤 심장·뇌에 벌어진 일 - 매일경제