4996개 이미지 쌍 구축…정확성·구체성·상황 관련성까지 종합평가 국제학술대회 ECCV 2026 채택
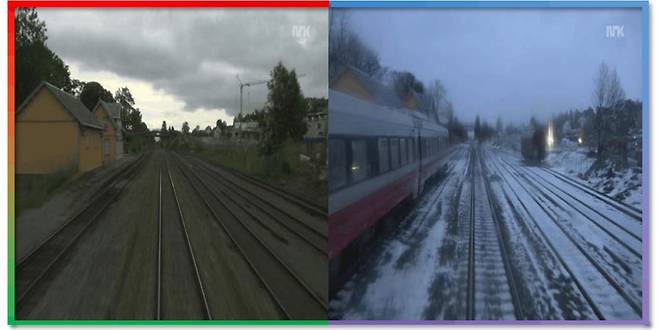
맥락에 따라 달라지는 ‘정답 변화’의 예. /제공=GIST
광주과학기술원(GIST)이 재난 감시와 자율주행 등 실제 현장에서 AI가 영상 속 핵심 변화를 얼마나 정확하게 파악하는지 검증할 수 있는 새로운 평가 기준을 개발했다.
GIST는 김의환 AI학과 교수 연구팀이 두 장의 이미지를 비교해 주어진 목적에 맞는 변화를 찾아 설명하는 ‘문맥 인식 변화 설명 평가체계(C3-Bench)’를 구축했다고 14일 밝혔다.
같은 철도 사진이라도 기상 관측에서는 눈이나 구름의 변화가 중요하지만, 안전 점검에서는 선로에 새로 나타난 열차가 우선 확인 대상이다. C3-Bench는 이처럼 AI가 눈에 보이는 차이를 나열하는 수준을 넘어, 상황에 필요한 변화를 선별하고 의미를 올바르게 설명하는지를 평가한다.
연구팀은 자연 장면과 위성·항공 원격탐사, 이미지 편집, 이상 탐지 등 4개 분야 51개 상황을 선정하고 사람이 변화 내용을 직접 작성한 4996개 이미지 쌍을 구축했다. 각 상황에는 AI가 찾아야 할 변화와 제외해야 할 차이, 설명 기준을 구체적으로 설정했다.
평가 방식도 정답과 같은 단어가 얼마나 포함됐는지를 따지는 기존 방식에서 벗어나 정확성·구체성·자연스러움·상황 관련성을 종합적으로 측정하도록 설계했다. 자동평가 결과도 사람의 판단과 비교해 신뢰도를 높였다.
연구팀이 400개 이미지 쌍을 대상으로 사람과 GPT-5.2를 비교한 결과, 4개 항목 종합점수는 10점 만점에 사람이 7.45점, GPT-5.2가 5.72점으로 1.73점 차이를 보였다. 문장 자연스러움은 GPT-5.2가 8.53점으로 사람의 8.32점보다 0.21점 높았다. AI가 매끄러운 문장을 만들면서도 영상 속 핵심 상황을 이해하는 능력은 별도의 검증과 개선이 필요하다는 사실을 수치로 확인한 것이다.
사진 순서를 바꿔 변화의 방향을 일관되게 설명하는 ‘가역성’ 평가에서는 사람이 93%, GPT-5.2가 61%를 기록해 32%포인트 차이가 났다. AI 오류 가운데 물체를 알아보지 못하거나 종류·특성을 잘못 판단한 시각적 인식 오류가 63.3%로 가장 많았다.
(왼쪽부터) AI학과 김의환 교수, 김재우 석·박사통합과정생. /제공=GIST
김의환 교수는 “C3-Bench가 재난·사고 감시와 원격탐사, 자율주행, 이상 탐지 등 현실 환경에서 AI의 변화 이해 능력을 평가하고 개선하는 공통 기반으로 활용되길 기대한다”고 말했다.
김재우 석·박사통합과정생이 제1저자로 참여한 이번 연구는 컴퓨터비전 분야 주요 국제학술대회인 ‘ECCV 2026’에 채택됐다.