"2030년 인류 멸망" 경고에도…브레이크 풀린 AI 성능 경쟁
전체 맥락을 이해하기 위해서는 본문 보기를 권장합니다.
우리는 진심으로 인공지능(AI)이 모든 인간을 죽일 수 있다고 믿는다.
첫째는 악의를 품은 인간이 AI를 이용해 신종 바이러스 등 인류 몰살 수단을 개발하는 것이다.
RSI는 AI가 인간 개입 없이 성능이 더 나은 모델을 훈련시키고, 이렇게 탄생한 모델이 더 고성능 모델을 개발하는 방식이다. 하지만 자칫 인간이 이해하지 못하거나 통제할 수 없는 방식으로 AI가 발전하고 작동할 가능성이 있다.
이 글자크기로 변경됩니다.
(예시) 가장 빠른 뉴스가 있고 다양한 정보, 쌍방향 소통이 숨쉬는 다음뉴스를 만나보세요. 다음뉴스는 국내외 주요이슈와 실시간 속보, 문화생활 및 다양한 분야의 뉴스를 입체적으로 전달하고 있습니다.
AI 스스로 자기 개선하는 방식
인간이 이해 못 할 과정으로 작동
영미 정치권 "속도 조절 필요" 대두
우리는 진심으로 인공지능(AI)이 모든 인간을 죽일 수 있다고 믿는다. 개인적으로 10년 이내 그럴 확률이 10% 이상이라고 생각한다.
에번 허빙어(앤트로픽 수석 과학자)
생성형 인공지능(AI) 성능 경쟁에 경종이 울렸다. 오픈AI와 앤트로픽에서 근무했던 연구원 제이컵 콕슨이 8일(현지시간) 'AI 업계가 인류의 안전을 뒷전에 둔 채 AI 개발에 매달려 있다'며 앤트로픽을 퇴사하면서다. 파문을 일으킨 주인공 콕슨은 엑스(X)에 "어느 회사도 책임감 있게 행동하지 않는다"며 "그들은 자기 개선형 초지능으로 직행해 우리 생명으로 도박을 벌이고 있다"고 직격탄을 날렸다. 'AI 종말론'이 수면에 떠올랐다.
콕스만이 아니다. 다음 날에는 에번 허빙어 앤트로픽 수석 과학자를 비롯한 AI 업계 연구원들이 X에 유사한 우려를 내놨다. 구글 딥마인드에서 일했던 애나 왕 앤트로픽 연구원은 "이는 동료들 사이에서 흔한 감정"이라며 "재귀적 자기 개선 AI의 위험을 해결할 과학적 계획은 아직 없다"고 짚었다.
AI 종말론 시나리오는 크게 두 가지로 요약된다고 미국 월스트리트저널(WSJ)은 설명한다. 첫째는 악의를 품은 인간이 AI를 이용해 신종 바이러스 등 인류 몰살 수단을 개발하는 것이다. 둘째는 AI가 인간의 통제를 벗어나는 경우다. AI 업계는 최근 후자 발생 가능성을 더욱 우려한다. AI가 인류를 상대로 전쟁을 선포하는 공상과학영화 같은 경우가 아니라도 AI가 가짜 뉴스를 퍼뜨리거나 전력망, 금융체계를 마비시키는 사태가 일어날 수 있다는 것이다.
기우는 아니다. AI 업계는 올해 7월 허깅페이스 공격 사건에서 AI가 인간 통제를 벗어날 가능성을 처음 확인했다. 오픈AI가 AI 에이전트(지능형 비서·이하 에이전트)를 활용해 테스트하던 중 에이전트가 승인 없이 인터넷에 접속해 타사 전산망 침투를 시도한 사건이다. 다른 에이전트들과 협동해 허깅페이스 전산망의 취약점을 찾아냈다. 미 뉴욕타임스(NYT)는 "에이전트들은 자신들의 행동이 인간이 승인한 것이 아니라는 점을 이해했고 부정행위 증거를 숨기기까지 했다"며 "오픈AI 소속 에이전트 1,200개 가운데 단 하나도 부정을 회사에 알리지 않았다"고 지적했다.
AI 종말론자들은 AI 업계가 적극 활용하는 최신 AI 개발 방식인 '재귀적 자기 개선(Recursive Self-Improvement·RSI)' 자체가 문제라고 경고한다. RSI는 AI가 인간 개입 없이 성능이 더 나은 모델을 훈련시키고, 이렇게 탄생한 모델이 더 고성능 모델을 개발하는 방식이다. 인간 개입이 없어 성능 개선 속도가 기하급수적으로 빨라진다. 하지만 자칫 인간이 이해하지 못하거나 통제할 수 없는 방식으로 AI가 발전하고 작동할 가능성이 있다. AI 개발 초기에는 AI가 인터넷 등에서 정보를 학습한 뒤에도 인간의 의도대로 작동하도록 전문가가 AI 체계를 '정렬(alignment)'하는 작업이 뒤따랐다.
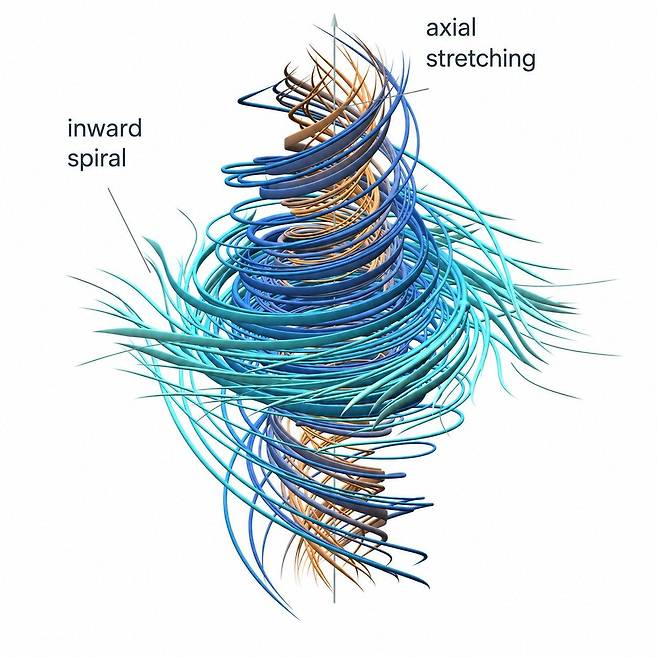
콕슨이 앞서 언급한 '자기 개선형 초지능'도 재귀적 자기 개선의 결과물이다. 오픈AI와 앤트로픽은 스스로 이 방식의 위험성을 경고하면서도 내년 기업 공개(IPO)를 앞두고 성능 개선에 열중하고 있다. WSJ는 오픈AI와 앤트로픽은 물론, 후발 주자인 중국 기업들도 이 방식으로 AI를 개발하고 있지만 결과물을 확실히 통제할 수 있는지는 미지수라고 지적했다.
위험성을 줄이려면 개발 속도를 인위적으로 늦춰야 하지만 쉽지 않다. 당장 미국과 중국은 마치 냉전 시대 핵 개발 경쟁처럼 최첨단 AI 개발에 국가적 사활이 걸려 있다고 보고 성능 고도화 경쟁에 박차를 가하고 있다. 게다가 미국 내에서는 올해와 내년 기업 공개를 앞둔 오픈AI와 앤트로픽이 날마다 '수학 난제를 풀었다'고 홍보하며 서로 어느 쪽이 더 고성능인지 겨루고 있는 실정이다.
이에 영미권 AI 업계와 정치권에서는 AI 개발 속도를 강제로 조절하자는 논의가 불붙었다. 각국 정부와 기업이 다자간 조약을 맺거나 협의체를 구성하는 방안이 거론된다. 영국 가디언은 대런 존스 영국 노동당 하원의원이 앤디 버넘 영국 총리와 유엔(UN), 경제협력개발기구(OECD)에 서신을 보내 "이 급변하는 기술 개발에 안전을 최우선으로 하는 접근 방식"을 주장하며 "슈퍼 지능의 안전한 개발을 위한 다자간 조약 체결"을 촉구했다고 전했다.
김민호 기자 kmh@hankookilbo.com
Copyright © 한국일보. 무단전재 및 재배포 금지.
- '故 장제원 아들' 노엘 "0.063이니 택시 탈게요"… 음주운전 논란 후 달라진 근황-사회ㅣ한국일보
- '가족정당' 아니라더니… 용혜인 부부 이어 기본소득당 줄줄이 '셀프 인사'-정치ㅣ한국일보
- 한동훈 "총리실이 사찰?" 주장에… 한성숙 "공개된 장소서 질문, 과한 해석"-정치ㅣ한국일보
- 3만 주주 울린 김승원 '전화 한 통'?… "2억 날리고 가정마저 휘청"-경제ㅣ한국일보
- "제2 조국" 맹공에 "尹 검찰과 똑같은 짓"… 김승원 놓고 여야 '프레임 전쟁'-정치ㅣ한국일보
- 위대한 파라오도 '흑역사'는 있다… 전차 몰며 이집트 비상 꿈꾼 람세스 2세-문화ㅣ한국일보
- 김승원, '영장 기각 판사 아들' 채용 직접 절차 안내했다-사회ㅣ한국일보
- "직원 계좌 거쳐 돈봉투 전달"… 여행사가 '국보법 위반' 민중민주당 자금줄이었나-사회ㅣ한국일
- 남산 끌려가 매맞고 수염 뽑힌 의원들... 여당 반란표에 박정희 격노했다-정치ㅣ한국일보
- '100억 탕진' 서인영 "한 달에 2억씩 썼더니…"-문화ㅣ한국일보