엔비디아 '기어랩', 로봇 기억 가능시간 '5분'으로 연장…융통성까지 갖춘다
전체 맥락을 이해하기 위해서는 본문 보기를 권장합니다.
엔비디아 산하 인공지능(AI)·로보틱스 연구소 '기어(Generalist Embodied Agent Research, GEAR)' 랩이 로봇의 '기억 가능 시간'을 5분으로 늘리는데 성공했다.
업계 관계자는 "ROBOTTT는 기존 싱글 스텝, 짧은 컨텍스트만 다루던 모델을 뛰어넘어 5분간 연속 동작을 기억할 수 있게 만든 기술"이라며 "로봇이 단계별 지침에 의존하는 것이 아닌 인간처럼 누적된 경험을 바탕으로 유연하게 행동하기 시작했다"고 말했다.
이 글자크기로 변경됩니다.
(예시) 가장 빠른 뉴스가 있고 다양한 정보, 쌍방향 소통이 숨쉬는 다음뉴스를 만나보세요. 다음뉴스는 국내외 주요이슈와 실시간 속보, 문화생활 및 다양한 분야의 뉴스를 입체적으로 전달하고 있습니다.
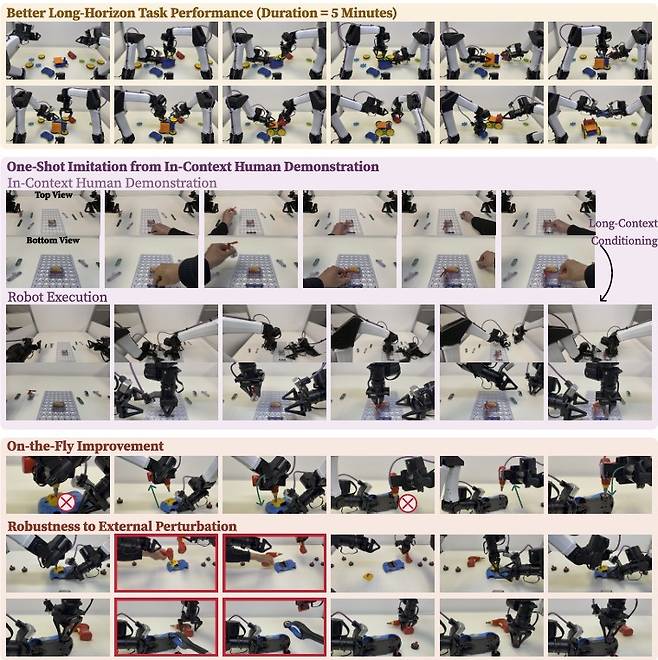
[더구루=홍성일 기자] 엔비디아 산하 인공지능(AI)·로보틱스 연구소 '기어(Generalist Embodied Agent Research, GEAR)' 랩이 로봇의 '기억 가능 시간'을 5분으로 늘리는데 성공했다. 기억력이 강화되면서 한 번의 시연으로 행동을 모방할 수 있는 능력, 실수했을 오류를 수정할 수 있는 능력까지 구현됐다. 로봇이 인간과 같이 '융통성'을 가지게 됐다는 평가가 나온다.
21일 업계에 따르면 기어랩이 스탠퍼드 대학교, 텍사스 대학교 연구진과 공동 집필한 'ROBOTTT:로봇 모델의 컨텍스트 확장(ROBOTTT: Context Scaling for Robot Policies)'이라는 논문을 공개했다. 해당 연구 결과는 논문 사전 공개 사이트 '아카이브(arXiv)'에 게재됐다.
논문에는 로봇의 시각-운동(visuomotor) 모델이 수용할 수 있는 컨텍스트를 1000배 이상 확장, 8000타임스텝(약 5분 분량 연속동작)까지 기억할 수 있게 됐다는 내용이 담겼다. 컨텍스트는 로봇이 카메라를 통해 본 영상, 자신의 팔 위치·각도 정보, 행동 이력 등을 말한다. 타임스텝은 로봇이 정보를 받아들이는 시간 단위로, 1타임스텝은 약 0.03초다.
그동안 트랜스포머 기술을 기반으로 로봇 AI 모델들의 컨텍스트는 1개~8개 타임스텝에 불과했다. 즉 앞선 1초간 본 것만 기억할 수 있었다는 것이다. 이렇게 되다보니 로봇 AI 모델의 상황 대응력은 바닥을 쳤다. 자동차 장난감에 지붕을 얹고 나사를 조이는 작업을 한다고 가정했을 때, 지붕 부품이 어떤 이유로 제대로 위치되지 않았지만 그 상황을 기억하지 못하고 입력된 단계대로 허공에 나사를 조이는 모습을 보여왔던 것이다.
기존 로봇 AI 모델이 컨텍스트를 마음껏 늘리지 못한 배경에는 메모리 사용량·계산량의 기하급수적 증가와 이에 따른 렉 발생이 있다. 기존 모델들은 화면에 담겨있는 모든 데이터를 그대로 저장하고, 다음 행동을 결정하기 위해 수집된 데이터 전부를 검색하는 형태로 돼있다. 영상을 보는 시간이 늘어나 찾아볼 데이터가 늘어나면, 그만큼 검색에 필요한 하드웨어 용량이 폭증하고 시간도 오래 걸리게 된다.
연구팀은 이런 문제를 해결하기 위해 최근 긴 문맥 처리의 연산 병목을 줄이는 방법으로 주목받고 있는 TTT(Test-Time Training) 기술을 적용했다. TTT 적용으로 1초의 영상에 담겨있는 모든 정보를 저장하지 않고, 실시간으로 확보된 데이터를 학습할 수 있게 됐다. 원본 데이터는 이 과정에서 삭제되기 때문에 필요한 자원의 양도 기하급수적으로 늘어나지 않는다.
TTT 기술 적용으로 ROBOTTT는 1번의 시연을 보고 바로 행동을 모방할 수 있는 능력을 가지게 됐으며, 성공한 모습 뿐 아니라 실패 상황도 한꺼번에 학습이 가능하기 때문에 문제가 발생하면 유연하게 다음 행동을 변화시킬 수도 있게됐다.
기어랩은 ROBOTTT의 전체 성능이 87% 향상됐을 뿐 아니라, 기존 모델이 단 하나도 완수하지 못한 5분 분량 10단계 조립과제를 완벽하게 완료해내기도 했다고 소개했다. 특히 8000타입스텝 컨텍스트를 학습한 ROBOTTT는 1000타임스텝으로 사전 학습된 모델보다 62% 높은 성능을 보여줬다고 강조하기도 했다.
업계는 이번 연구로 컨텍스트 길이가 로봇 파운데이션 모델의 성능을 결정짓는 중요한 조건이라는 것을 보여줬다고 평가했다.
업계 관계자는 "ROBOTTT는 기존 싱글 스텝, 짧은 컨텍스트만 다루던 모델을 뛰어넘어 5분간 연속 동작을 기억할 수 있게 만든 기술"이라며 "로봇이 단계별 지침에 의존하는 것이 아닌 인간처럼 누적된 경험을 바탕으로 유연하게 행동하기 시작했다"고 말했다.
Copyright © THE GURU의 모든 콘텐츠(영상·기사·사진)는 저작권법의 보호를 받은바, 무단 전재와 복사, 배포 등을 금합니다.
- LG전자, '중국 1호 법인' 후이저우 공장 10월 문 닫는다…생산 거점 효율화 전략 가동
- 씨젠, 세계 첫 HSV·VZV·MPXV 통합 PCR 美 FDA 긴급사용승인
- '배민' 품은 우버, 99개 글로벌 시장 배달플랫폼 구축
- 블랙록, 메타 데이터센터 건설 위해 17조 이상 채권 발행 추진
- 미국 증시 공매도 잔고 사상 최대…AI 투자 우려에 약세 베팅 급증
- 한국중부발전, 베트남 빈탄 4 화력발전 기술협력…국내 전력기업 동남아 판로 개척 '물꼬'
- 신세계인터 어뮤즈, 英서 K뷰티 넘버원…스킨1004·조선미녀 뒤이어
- 캐나다 실패 딛고 한화오션, '1조8000억 규모' 대만발 대형 컨테이너선 6척 수주
- 비비안, 복지 아동에 2000만원 쾌척…가수 태진아 동참
- 골드만삭스 "헤지펀드, 미국 기술주 두 달간 사상 최대 규모 매도"